E
Enhar Ormeci
Misafir
Misafir
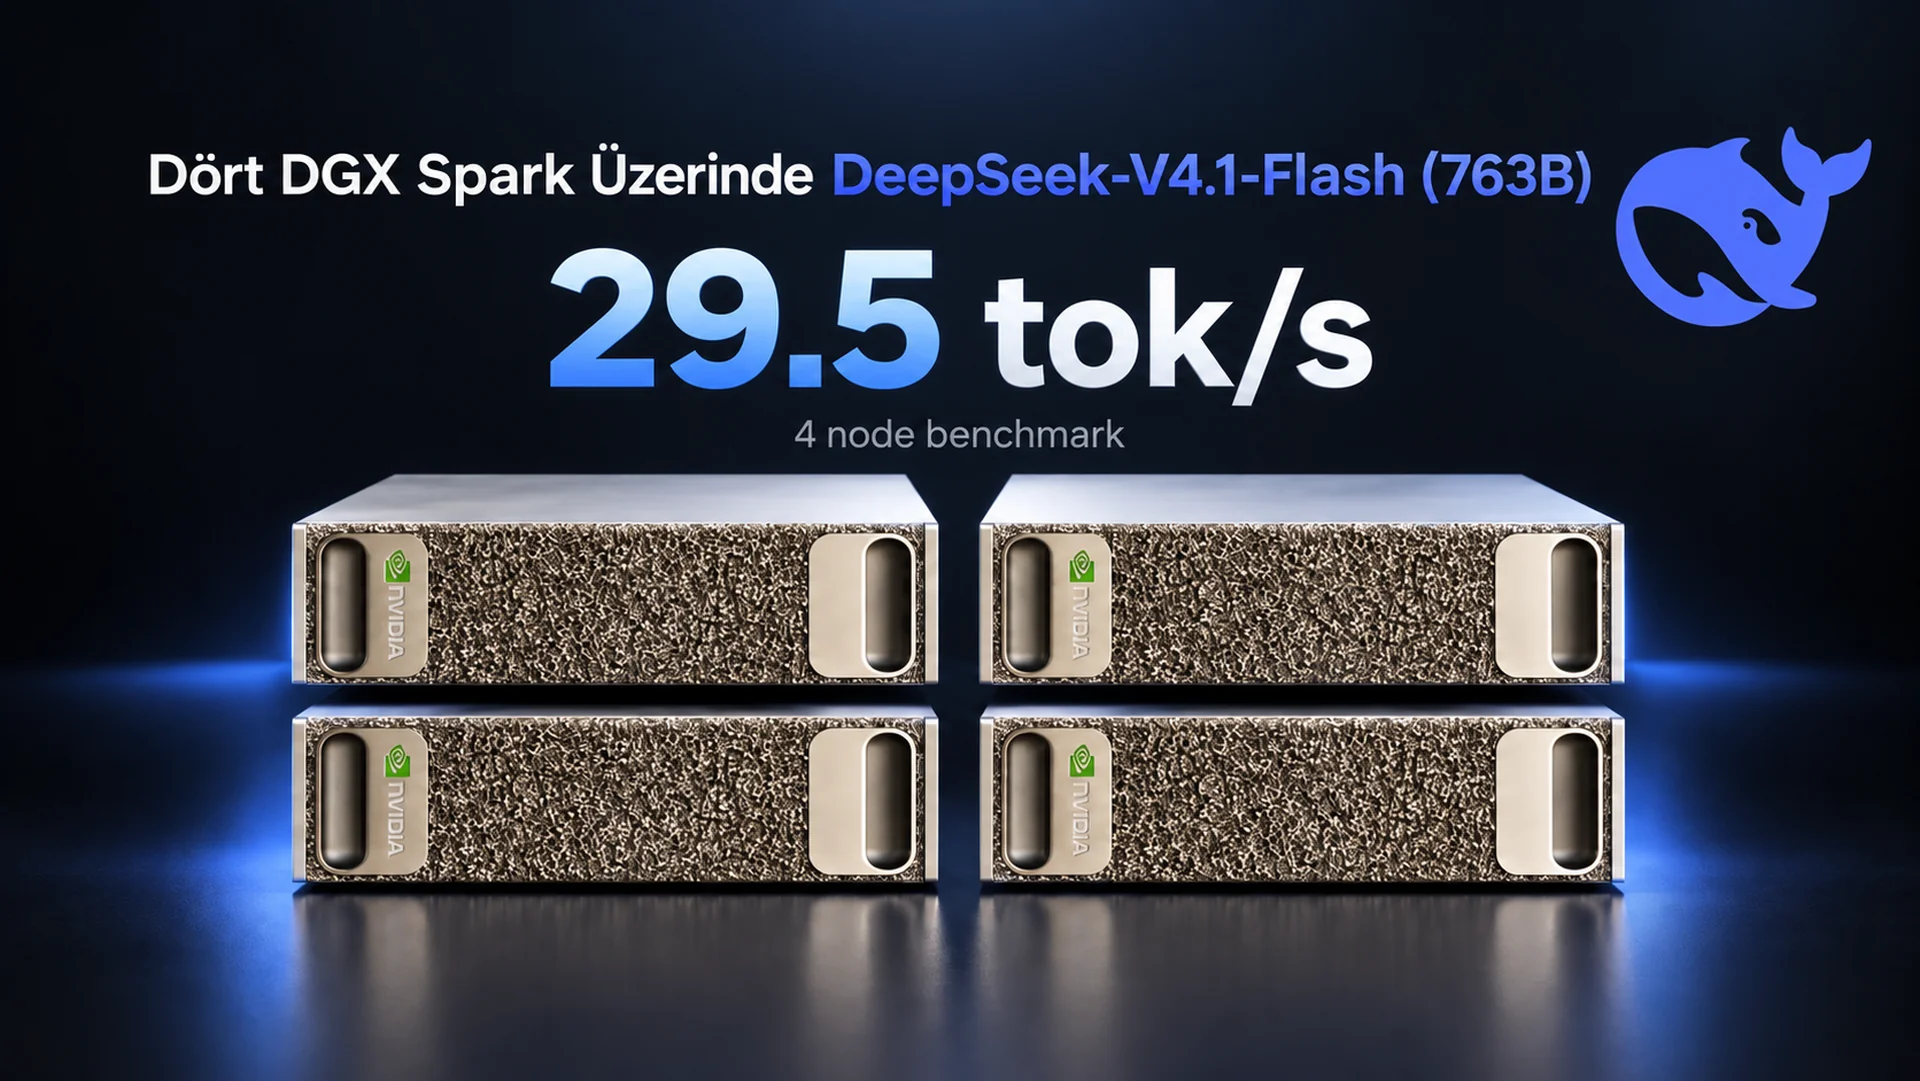
DeepSeek-V4.1-Flash, 552 milyar parametrelik bir omurgaya sahip, çok modlu bir Mixture-of-Experts (MoE) modelidir. Hugging Face checkpoint’i 763 milyar parametre içerir: 552B omurga + 196B Engram koşullu bellek + ~15B görsel kodlayıcı, MLP projektörü ve DSpark draft modeli. MXFP8 dense + MXFP4 expert ağırlık nicelemesi ve FP4 (E2M1) KV önbelleği ile gelir; 1 milyon token’a kadar bağlam destekler.
Bu model normalde DGX-B300 / GB300 NVL72 sınıfı veri merkezi donanımında servis edilir. Bu eğitimde ise onu, toplam 512 GB birleşik belleğe sahip dört DGX Spark’tan oluşan bir küme üzerinde çalıştıracağız. Bu dağıtım; dört düğümlü tensor parallelism (TP=4), Engram-on-disk modu ve DSpark speculative decoding sayesinde mümkün oluyor. Ulaşacağımız sonuç: tek eşzamanlılıkta (C=1) saniyede 29.5 token üretim hızı.
Not: Bu çalışma bir benchmark karşılaştırması değil, bir dağıtım rehberidir. Ölçümler dört veri noktasıyla sınırlıdır; yine de bu donanım sınıfının neler yapabildiğini göstermesi açısından değerlidir.
Spark, monitör ve klavye bağlayarak doğrudan bilgisayar olarak kullanılabileceği gibi, başka bir bilgisayarla uzaktan bağlanılan bir sunucu olarak da kullanılabilir. Biz bu eğitimde Spark’lara uzaktan bağlanacağız ve gerekli yazılımları kurup modeli çalıştıracağız.
Çıkarım motoru olarak vLLM, yönetim aracı olarak sparkrun kullanacağız. vLLM, modelin ağırlıklarını dört düğüme dağıtıp dışarıdan istek kabul eden bir API sunacak. sparkrun ise komut satırı üzerinden Docker konteynerlerini ve Spark’lar arasındaki model dağıtımını yönetecek; imaj senkronizasyonu, model aktarımı ve küme yapılandırması gibi işlemler otomatik olacak. vLLM’in stock nightly imajı, GB10 (SM 12.1a) için gerekli kod yollarını içermediğinden bu eğitimde yedi patch içeren özel bir imaj kullanacağız.
Bu eğitim beş bölümden oluşur:
Model ve Mimari: DeepSeek-V4.1-Flash’ı bu donanıma sığdıran mimari özellikler
Kurulum: Docker imajının hazırlanması ve recipe oluşturma
Çalıştırma: Modeli dört Spark üzerinde başlatma, izleme ve test etme
Benchmark: Farklı eşzamanlılık seviyelerinde performans ölçüm sonuçları
Kapatma: Servislerin durdurulması
Eğitim boyunca ana cihaza Main Spark, diğer üç cihaza ise Worker Spark denileceğini unutmayın.
TAVSİYE EDİLEN ÜRÜNLER
Bu bağlantıyı görüntüleyebilmek için kayıt olmalı zaten üyeyseniz üye girişi yapmalısınız.
❮
Bu bağlantıyı görüntüleyebilmek için kayıt olmalı zaten üyeyseniz üye girişi yapmalısınız.
Bu bağlantıyı görüntüleyebilmek için kayıt olmalı zaten üyeyseniz üye girişi yapmalısınız.
Bu bağlantıyı görüntüleyebilmek için kayıt olmalı zaten üyeyseniz üye girişi yapmalısınız.
Bu bağlantıyı görüntüleyebilmek için kayıt olmalı zaten üyeyseniz üye girişi yapmalısınız.
❯
Bu bağlantıyı görüntüleyebilmek için kayıt olmalı zaten üyeyseniz üye girişi yapmalısınız.